AIに"目"を与える — 本番システムを観測できるエージェントへ
はじめに
AIエージェントにコードを読んでもらい、書いてもらうことは、日常のものになりました。ただ、コードを読めることと、システムを理解していることは別です。本番で何が起きているか、ユーザーがどう使っているか、数字がどう動いているかは、コードのどこにも書かれていません。
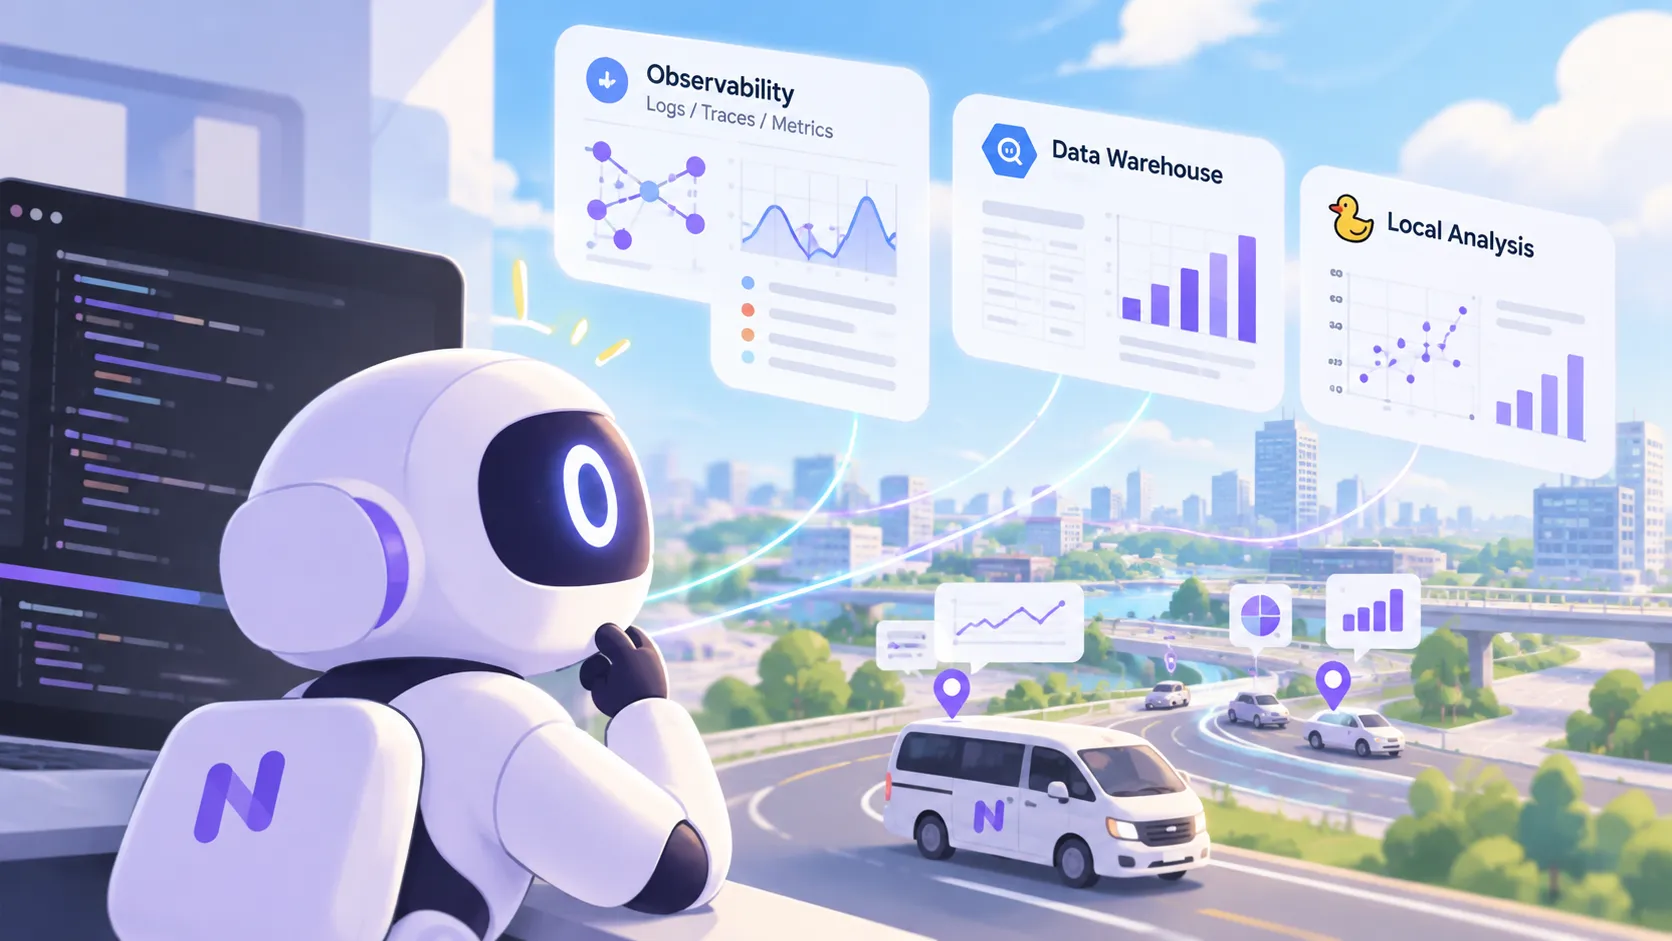
AIエージェントは、開発環境の中のものはすでに自分で見ています。本記事で目と呼ぶのは、その外側にある、本番で動いているシステムと、それを使っているユーザーの実態を観測する手段です。前回の記事で、差がつくのはモデルではなく、モデルを取り巻くハーネス(指示書、ツール、権限、検証の仕組み)だと書きました。目は、そのうちのツールと権限を本番システムの側へ伸ばしたものにあたります。
NearMeでは、オブザーバビリティ基盤とデータ分析基盤をこの目として接続してきました。目を持ったエージェントは、障害調査からアルゴリズムの改善提案までを任せられる存在になりつつあります。本記事では、その目をどう構築し、どう活用しているかを紹介します。前回同様、ここに書くことは現時点のスナップショットです。
コードは静的、システムは動的
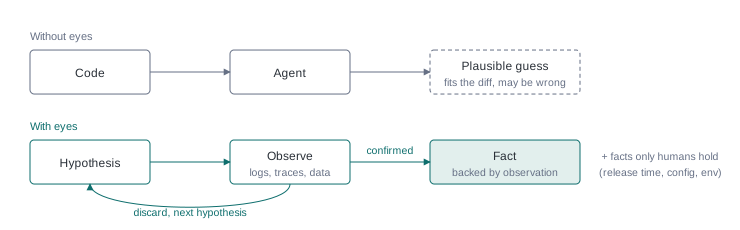
AIにコードだけを渡して「この不具合の原因を調べて」と頼むと、AIは差分を読み、変更の中から症状に合いそうなものを探し、もっともらしい仮説を組み立てます。この仮説は、コードから導ける範囲では筋が通っていることが多く、そこが厄介です。実際に先日、あるAPIへの呼び出しが短時間に集中する現象をまずコードだけで調べさせたところ、最近の変更の中から「症状と形が合う」ものを挙げてきましたが、後に観測データで確かめると、それは原因ではありませんでした。指示が足りなかった可能性もありますが、コードだけで原因を特定するのはAIにも難しいはずです。
コードは静的ですが、システムは動的です。どのバージョンがいつ本番に出たのか、どの端末からどんな頻度でリクエストが来ているのか、外部サービスが何を返しているのか、データがどう偏っているのか。こうした事実は、動いているシステムを観測しなければ分かりません。目のないAIは、どれほど賢くても、暗闇の中で手探りをしているのと同じです。
逆に、観測の手段を与えると、AIは仮説を自分で確かめられるようになります。仮説を立て、データで確かめ、合わなければ捨てて次の仮説へ進む。この仮説→観測→棄却のループを、人間が逐一データを取ってきて渡さなくても、AI自身が回せるようになります。
NearMeが整備している”目”
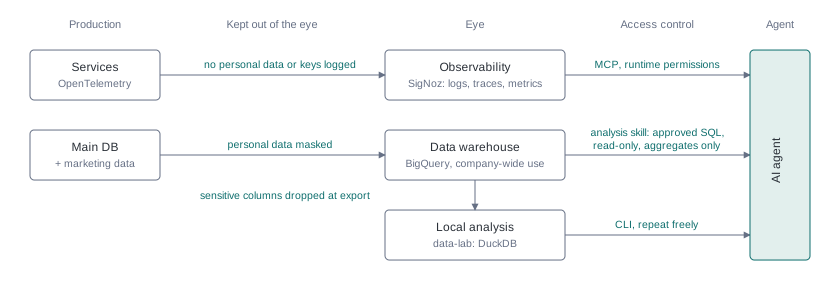
NearMeでは、本番システムを観測するための目をAIエージェントに接続しています。ここでは代表的な三つを取り上げます。いずれもMCP(Model Context Protocol)やCLIを通じて、エージェントが自分でクエリを発行し、結果を読める形です。なお、SlackやNotionなど、社内のやり取りや文書を読むための接続もありますが、本記事の範囲外とします。
1. 観測の目 — オブザーバビリティ基盤
各サービスからOpenTelemetryで送られるログ、トレース、メトリクスを集約しているオブザーバビリティ基盤(SigNoz)を、MCP経由でエージェントから直接検索・集計できるようにしています。
この目で見えるのは、たとえば次のようなことです。
- あるAPIの呼び出しが、秒単位で見ると短時間に集中している
- その集中が特定のOSやクライアントだけで起きていて、毎回一つの端末から来ている
- 本番の各サービスがどのバージョンで動いていて、いつ切り替わったのか
- 外部サービスへの呼び出しが、どの時間帯にどんな応答コードを返したか
こうした掘り下げは人間がダッシュボードでもできますが、粒度や軸を変えて眺め直す作業は手間がかかり、途中で切り上げて見落とすこともあります。エージェントは、時間単位から分単位、秒単位へと、仮説に合わせて切り口を変えながら根気よく掘り進めます。
冒頭のAPI呼び出しが集中する現象も、この目で本番の挙動を集計して、どの条件でいつから起きているかまで絞り込めました。目があることで、調査は「それらしい説明」で止まらず、観測で裏づけられた事実まで進みます。SigNoz MCPを入れてから、不具合の原因究明から解決までのリードタイムは、体感でかなり短くなりました。
調査の途中で「この情報が記録されていないので絞り込めない」と、目の足りない箇所をエージェント自身が指摘してくることもあります。何を記録しているかが、AIに何を見分けられるかを決めます。
2. アドホック分析の目 — データウェアハウス
本体データベースのデータは、個人情報や重要情報を除いたうえでBigQueryに集約しています。マーケティング関連のデータも同じ場所にあり、予約データと突き合わせられます。
この目は、社内で最も活用が進んでいます。エンジニアに限らず、PdM、営業、オペレーション、コーポレート部門でも、実績レポート、KPIの定点観測、キャンペーン別の予約状況の確認など、さまざまな用途で全社的に使われています。
全社的に使えている理由は、単にBigQueryをAIに繋いだからではありません。分析スキルとして、社内の指標定義書やテーブルの注意事項をAIに先に読ませ、定義に沿ったSQLを提示し、人間が承認してから読み取り専用ツールで実行する、という手順をスキルに組み込んでいます。これにより、SQLを書けない人でも、組織として合意された定義で数字を出せます。一度作った分析の切り口はレシピとして共有され、次の人が同じ定義で再実行できる仕組みです。
利用者側の準備も欠かせません。配布して終わりにせず、使い方や注意点を十分にレクチャーしたうえで使ってもらっています。また、スキルには、期間の絞り込みを必須にする、大量のデータをそのまま取り出さず集計値で返す、といった制限を組み込んでいます。
3. 本格分析の目 — ローカル分析環境
もう一つ、より詳しい分析のために、本番相当のデータを手元に持ってくる環境(data-lab と呼んでいます)を用意しています。必要なテーブルをBigQueryから期間指定でローカルのDuckDBに取り込んで、何度でも高速に叩けるようにしたものです。
クラウドのウェアハウスに毎回問い合わせるとコストも待ち時間も嵩みますが、手元にあればその心配がありません。分析に必要なビューも、エージェントに気軽に作らせて積み上げていけるので、より高度な分析に進みやすいのが特徴です。
見せないものを決める
目を広げるほど、見えてはいけないものまで見えるようになります。どの目にも、性質の異なる歯止めを重ねています。
- データ側で入れない・落とす。オブザーバビリティ基盤のログやトレースには、個人データや、漏れてはいけない認証情報などのキー情報を入れない設計にしています。データウェアハウスとローカル分析環境では、個人情報や重要情報の列は取り込みの時点で除外し、エージェントの手元に届かないようにしています。
- 指示で読まない。分析スキルには、残っている列の中でも個人を特定しうるものは参照も抽出も出力もしない、結果は集計値のみ、というルールを組み込んでいます。
- 実行時に止める。エージェントの実行環境(Claude Code)の自動モードには、操作の内容を見て、個人を特定する形の取り出しなどを止める分類器があります。万一、個人に紐づく情報がログに混入していた場合の最後の層ですが、決定的なルールではなく最善努力です。
原則は「個人情報は目に入れない」で、指示と実行時の制御はその保険です。
目に映るものを命令として扱わない
目を広げるときのもう一つの注意点が、プロンプトインジェクションです。ログやデータベースの自由記述欄、社内のやり取りには外から来た文字列がそのまま入っていて、そこに書かれた「指示」をエージェントが命令と取り違えるおそれがあります。これは本番を見る目に限らず、リポジトリ内のファイルやPRの本文、サブエージェントの報告、MCPサーバー自身の指示文など、エージェントが読むものすべてに当てはまります。
対策は何層にも重ねます。まず、読ませる外部由来の文章を減らします。ユーザーの入力をログにそのまま残さないのは個人情報保護のために以前からある実践で、ここでもそのまま有効です。データベースの自由記述の列も、必要なときだけ注意を添えて読ませます。次に、観測した文章には従わないと指示したうえで、取り違えたときの実害を設定で限定します。実行できるコマンドやツールを権限ルールで絞り、本番データや外部サービスへの書き込みなど影響の大きい操作には人間の確認を挟みます。ただし権限ルールは万能ではなく、確認対象外の操作を判断する自動モードの分類器は観測内容を見ません。本当に境界を引くには、コマンド実行をOSの機構で隔離するサンドボックスが要ります。組み込みのものが覆うのはコマンドとその子プロセスまでで、MCP経由の操作まで境界に入れるには、プロセス全体を隔離する環境が必要になります。最後に、通り抜けたものを止めるのは、成果物に対する人間のレビューです。
人の役割
目を持ったAIが調査も分析も進めるようになっても、人間に残る役割が三つあります。
一つは、問いを立てることです。「このあたりから負荷が尖っている」「前回より指標が下がった気がする」。調査や分析の出発点は、いずれも現場の人間の観察でした。AIは目を与えられても、何を見るべきかまでは自分で決められません。
もう一つは、AIの目が届きにくい事実を持ち込むことです。たとえばストアの公開時刻や設定値の実態は、AIの目では捉えにくい情報です。冒頭の現象の調査でも、原因の候補を絞り込んだのは、人間が持ち込んだこうした事実でした。前回の記事で書いた、現地現物の情報の価値そのものです。
最後に、AIの分析結果を疑うことです。目を持ったAIの報告は、観測データに裏づけられている分だけ説得力があります。それでも「なにかおかしい」と感じて再調査させ、結論が覆ったこともありました。AIの結論を最終判断にせず、現場の感覚と照らして疑う役割は、人間に残ります。
おわりに
前回、AI適応の次の段階として、リリース後の評価・改善までを任せるLv5を挙げました。リリース後の評価には、システムとユーザーの実態を観測することが欠かせません。目の整備は、Lv5に向かうための前提条件だと考えています。その一歩として、エージェントが本番のログとデータに安全に届く状態を整えています。
AIに本番の事実を直接見せて判断させれば、AIの潜在能力はもっと引き出せます。ただし、目を与えることはツールを一つ繋ぐことではありません。何を記録し、何を見せないかを設計し、目と一緒に広がるセキュリティのリスクに歯止めをかけながら、育て続けていく必要があります。